

引言
如果一个浏览器从第一天起就是为 AI Agent 设计的,它还会是成今天 Chrome 的样子吗?
我们的答案是 Moli,一个从零用打造、专为 AI Agent 设计的浏览器内核。它可以作为大规模浏览器集群或边缘节点场景下零成本替换 Chrome。在我们内部的 Agent 工作负载测试中,Moli 的常驻内存约为 Chrome 的 1/7,冷启动速度快 5 倍左右;功能和稳定性已经在生产环境验证。
这篇文章会讲清楚这些数字从哪来,传统浏览器的架构为什么对 Agent 来说是一种浪费,以及 Moli 具体做了哪些取舍。
为什么要重新做一个浏览器
Lexmount 云平台部署了我们的 Chromium fork: Ace, 我们在它上面做了很多工作。但是在规模部署 AI Agent 浏览器场景下(比如 大规模网页自动化/RL 后训练) 我们发现了一些资源浪费,并且很难把它们干净的裁剪掉:
资源贪心下载
大部分 AI Agent 操作网页的场景并不需要下载资源,如图片、字体、音视频等。大部分资源的存在与否并不影响 Agent 理解网页。如果 Agent 真的需要对应的资源,也大可以在网页加载完毕之后获取 DOM 节点,找到链接,再单独下载。
但是 Chromium 设计思路是视觉优先,将这些资源视为重要的渲染资产,甚至有不少优化是为了尽早将这些资源加载完成(比如在流式的 HTML 解析过程中会做资源的预取,这会让常规脚本和 CSS 的下载更慢)。这些资源文件挤占核心网页文件下载的网络带宽,进而会拖慢整体的加载速度。
这些资源下载和浏览器内核耦合比较深,Chromium 并没有暴露干净易用的过滤方式。
我们是否有可能将这部分资源下载变成可选让 AI Agent 控制?
持续运转的浏览器渲染管线
浏览器渲染管线简介
浏览器的渲染管线有点复杂,这里简化概括介绍一下:

为方便理解,本文统一将渲染过程抽象为以上几个阶段。不同渲染引擎的具体数据结构和命名有所不同。例如本文所说的 Box Tree,在 Chromium 中大致对应 LayoutObject Tree,在 Firefox 中大致对应 Frame Tree;本文所说的 Layout Tree,在 Chromium 中主要对应布局产生的 Fragment Tree,而 Firefox 则主要将布局结果保存在 Frame Tree 及相关结构中。
阶段 1: HTML + CSS
一开始网页只是 HTML + CSS 源码:

<main>
  <h1>Hello World!</h1>
  <button>CONTINUE</button>
</main>
h1 {
font-size: 24px;
}
.button {
background: purple;
}阶段 2: DOM 树 + CSSOM 树:把结构和样式解析计算出来
浏览器下载和解析 HTML CSS 之后会持续维护网页 DOM 树和 CSSOM 树:

HTML 被 parser 转成 DOM:
main element
├── h1 element
└── button element
与此同时,CSS paser 会解析 CSS 并通过 selector 匹配这些元素,然后经过 cascade、inheritance 等过程,得到每个元素最终的 computed style。
h1
    font-size: 24px
    display: block

button
    background: purple
到了这一层,浏览器已经知道页面有什么,以及每一个东西有什么视觉属性。
阶段 3: Box 树:从结构变成参与排版的盒子
接下来发生了一个非常重要的转换。
DOM 描述的是页面元素,但 Layout Engine 真正需要操作的是视觉 Box。
在这个阶段,图里的 <h1> 开始变成一个 CSS Box。这时候开始出现我们熟悉的网页 Box 模型:
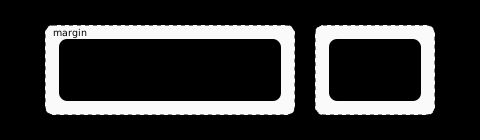
为什么不能直接拿 DOM 做 Layout 呢?这里举两个例子:
- 如果有一个元素 CSS 标记不显示:
display: none;这样的元素元素不会产生参与排版的 Box
- 如果有一个 css style 标记了
::before:
.foo::before {
  content: "★";
}
::before 不是真正的 DOM child,却会产生视觉 Box (内容是 *)参与排版。
为了让排版系统更专注于排版,浏览器渲染流水线中一般都有 Box 树作为中间层桥接 DOM 树和 Layout 树。
阶段 4: Layout 树 + Text Shaping:给每一个 Box 真正的坐标和大小
有 Box 之后,仍然不知道它具体的位置和大小。
在这一层 Layout Engine 开始通过 Box 对应的 Computed Style 和排版规则(flex, grid etc.) 计算元素几何。

图中 Hello World! 的 Box 最终会得到类似的属性:
x, y = (35, 35)
width, height = (190, 30)
同时文字 Hello World! 会进入字体布局引擎:
字体选择
     ↓
字符映射字形
     ↓
字距调整 / 整形
     ↓
换行处理
     ↓
基线 / 行盒
于是浏览器才真正知道每个字在哪里,行宽、基线、文字高度之类的信息,最终计算结果保存为 Layout 树。
阶段 5. Paint:把布局几何可视化
到了 Layout 结束时,浏览器已经知道每个 Layout 树元素的位置,长宽,颜色等等属性。

Paint 阶段把这些信息转换成绘制操作,并最终渲染到画布上。这一层结束后,人类视角里的网页就已经产生了。
渲染管线到处都是缓存
为了让网页保持 60 FPS,浏览器必须在十几毫秒内完成一帧更新。
所以 Chrome 的 Blink 会长期保存渲染管线各阶段的中间状态:
DOM
 ↓
Box Tree        → 缓存哪些元素参与布局,以及它们的盒子结构
 ↓
Style           → 记录哪些节点需要重新计算样式
 ↓
Layout          → 缓存元素的位置、大小和布局结果
 ↓
Paint           → 复用没有变化的绘制命令、光栅化结果
这对人类浏览器很合理,因为用户随时可能滚动、hover 或播放动画,但 AI Agent 的行为模式不同,举两个例子:
- Agent 打开一个网页,在之后几秒钟里只读取 DOM、文本、网络响应和 JavaScript 状态,根本不关心这个 div 此刻到底是 183px 还是 187px。
- Agent 打开一个网页,截取一次图像,之后几秒钟去做各种别的分析任务,过了几秒钟才再截取一次图像,再做别的事情
对于这种场景,与其一直保存上一帧等待下一帧,不如真正需要时再计算,反而可能更省内存和 CPU。这部分逻辑和内核耦合很深,也依然无法干净改造。
Moli: 重新定义 AI Native 浏览器
如果浏览器从第一天起就是为 AI Agent 设计的,它还应该沿用今天的架构吗?
AI Agent 绝大多数时间需要的是 DOM、文本、链接、表单状态、网络响应和可执行的页面语义;只有在遮挡、弹层、空间关系或最终结果需要确认时,它才真正需要渲染结果。它需要的是一个能够理解网页、执行网页,并在必要时看见网页的浏览器,而不是一块永远占用大量内存的虚拟屏幕。
Moli 是我们给出的答案:
Moli 是一个面向 Web Fetch 和 BrowserUse、为 AI Agent 重新设计的浏览器内核。
在典型 Agent 工作负载中,Moli 的常驻内存可以降到 Chrome 的约 1/7,峰值内存为 Chrome 的 1/3;而常规浏览器能力 iframe、Worker、Wasm、Cookie、WebCrypto、IndexedDB、OPFS,以及 CDP/WebDriver 调试能力仍然在同一套浏览器内核中完整实现。
除此之外,我们还专为 Agent 设计了各种控制网页加载的功能,相比于传统浏览器,moli 把如何访问到想要的内容的控制权交给了 Agent.
按需的渲染管线
传统浏览器渲染管线已经在上面介绍,这里不赘述。
Moli 最激进的设计发生在渲染渲染管线的缓存设计:
- Moli 的渲染链路则是一次性、无缓存的。它每次渲染从当前 DOM 和 CSSOM 重新执行 Box Builder、layout、文本排版和 CPU paint,生成一帧 frame。低频 CDP Screencast 只是按固定节奏重复同一套 one-shot pipeline。
- Moli 只在有图像请求时发起完整的浏览器渲染
这在低频浏览器操作场景优势明显: 页面不渲染时,没有常驻 Box Tree/Layout Tree 的内存成本;在少量低频渲染时,从头执行渲染的 CPU 开销也并不明显(<30ms),整体算下来比 Chromium 还低。
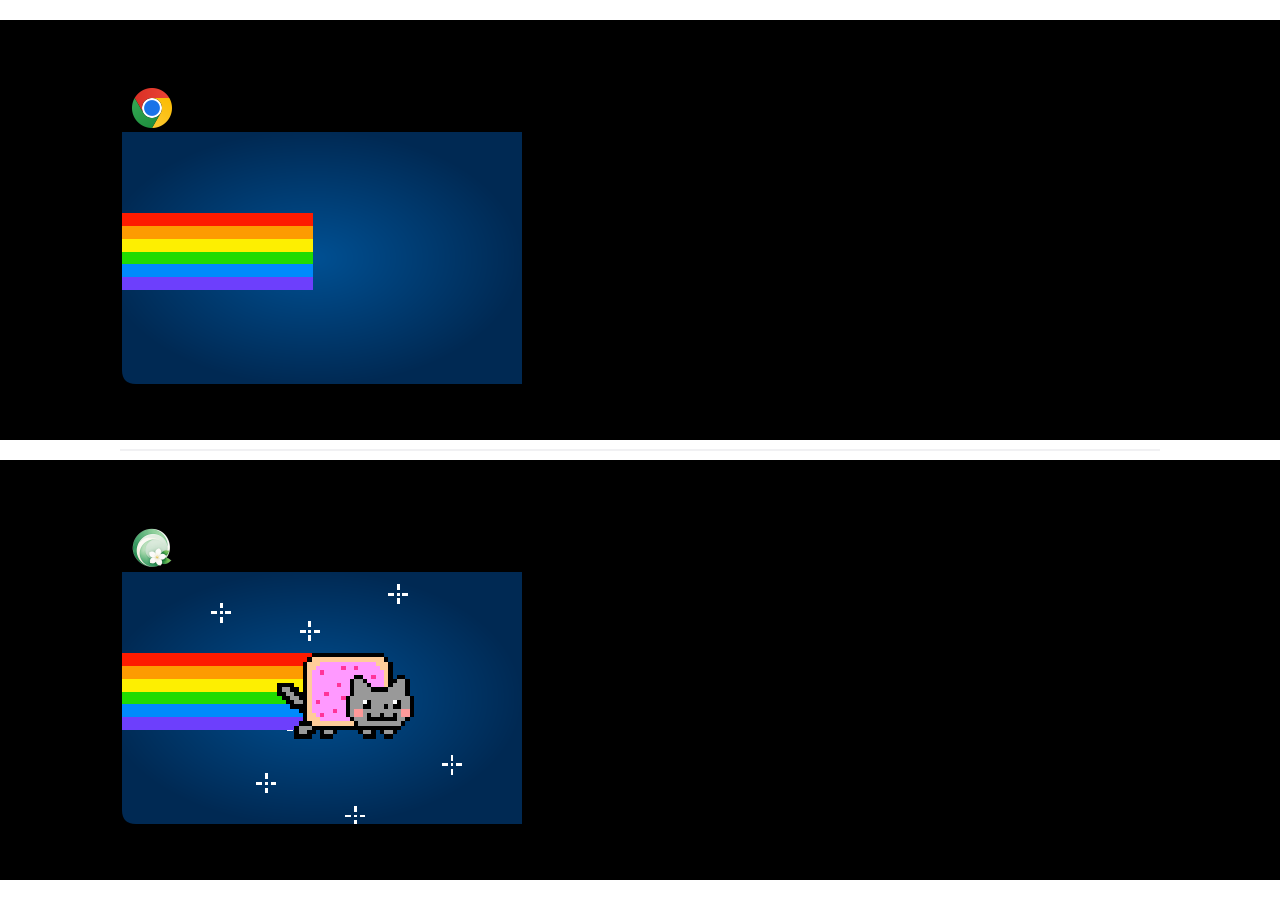
Moli 的内存优势也因此成为架构本身的直接结果,不依赖任何单一的神奇优化。
单二进制,多种自动化协议支持
浏览器领域有三个绕不开的调试协议:CDP、WebDriver-Classic、WebDriver-BiDi。
常用的浏览器调试和测试框架如 Playwright、BrowserUse 倾向使用 CDP,而 Selenium 倾向使用 WebDriver Classic 和 BiDi。
对于 Chrome 和 Firefox,WebDriver 协议往往需要安装额外的二进制(ChromeDriver, GeckoDriver)才能使用,版本号还必须严格对齐,这些依赖安装在 AI Agent 场景里非常容易导致失败。
而 Moli 原生实现了三种协议,无任何依赖,Playwright/BrowserUse/Selenium 可以直接连,不需要单独安装浏览器或驱动。

Moli 的完成度很高
Moli 不是一个大号 curl。我们投入了大量精力,让 moli 真正变得 production ready:
WPT 通过情况
对于 Web 标准,我们用 WPT(web-platform-tests) 测试集跑过完整测试,目前已通过其中 161.2 万条测试 case。
其中核心能力如 Fetch、XHR、Forms、Worker、WebStorage、WebCrypto、Wasm 等部分的 WPT 测试,我们都做到了和 Chromium 一样的覆盖率。
浏览器 Web 安全基础语义:CORS、CSP、CORP、COEP、Cookie 和存储分区等,Moli 都做了完整实现和详细的回归,这是 AI Agent 使用场景最基本的保障。
自动化协议支持
对于自动化协议,WebDriver Classic/BiDi 部分属于 Web 标准,有 WPT 覆盖,但是对于 Chrome 设计的 CDP 行为,是没有标准的,为此我们构建了 LexBench-Headless-Browser,使用 13 种不同但常见的浏览器自动化框架对 Moli 进行了行为兼容 + Web 标准支持的混合 Benchmark,结果如下

(其中我们使用 Cloudflare 公开 CDP 端点,对 Cloudflare 公开发布但未开源的 KiteSurf 也进行了 Benchmark)
Moli 不仅支持了所有常见的浏览器框架,还超过了所有目前已知的 Headless 浏览器实现
综合结果
对 WebAPI 标准的完善支持使得 moli 在真实使用场景下表现优异:
-
由于前端开发框架广泛使用和足够复杂,我们特地构造构造了 1000 多个复杂的 Vue, React, Angular 网站,并与 Chromium 进行了加载过程中 DOM 树变化的逐帧对比,结果是完全一致的。
-
我们还使用 192 个公开 URL,混合了中文社区与英文世界头部站点,测试网页核心内容抓取,结果如下:
| 引擎 | 有用页面 | 成功率 | 中位耗时 | Median RSS |
|---|---|---|---|---|
| Moli | 103 | 53.6% | 1.43s | 73 MiB |
| Chrome-Headless | 101 | 52.6% | 1.43s | 773 MiB |
| Lightpanda | 85 | 44.3% | 0.97s | 40 MiB |
| Obscura | 57 | 29.7% | 1.30s | 39 MiB |
这里的成功不仅要求浏览器收到 HTTP 200 和正常退出:页面必须产出可用的渲染后内容;CAPTCHA / 人机验证、JavaScript challenge、拦截页、登录墙、空响应和只有 app shell 的页面全部计为失败。
这里 Moli 比 Chrome 还高是因为 Chrome Headless 模式下会强制在 UA 插入类似
HeadlessChrome/151.0.0.0的特征么,使得其更容易被 WAF 拦截。
真实场景
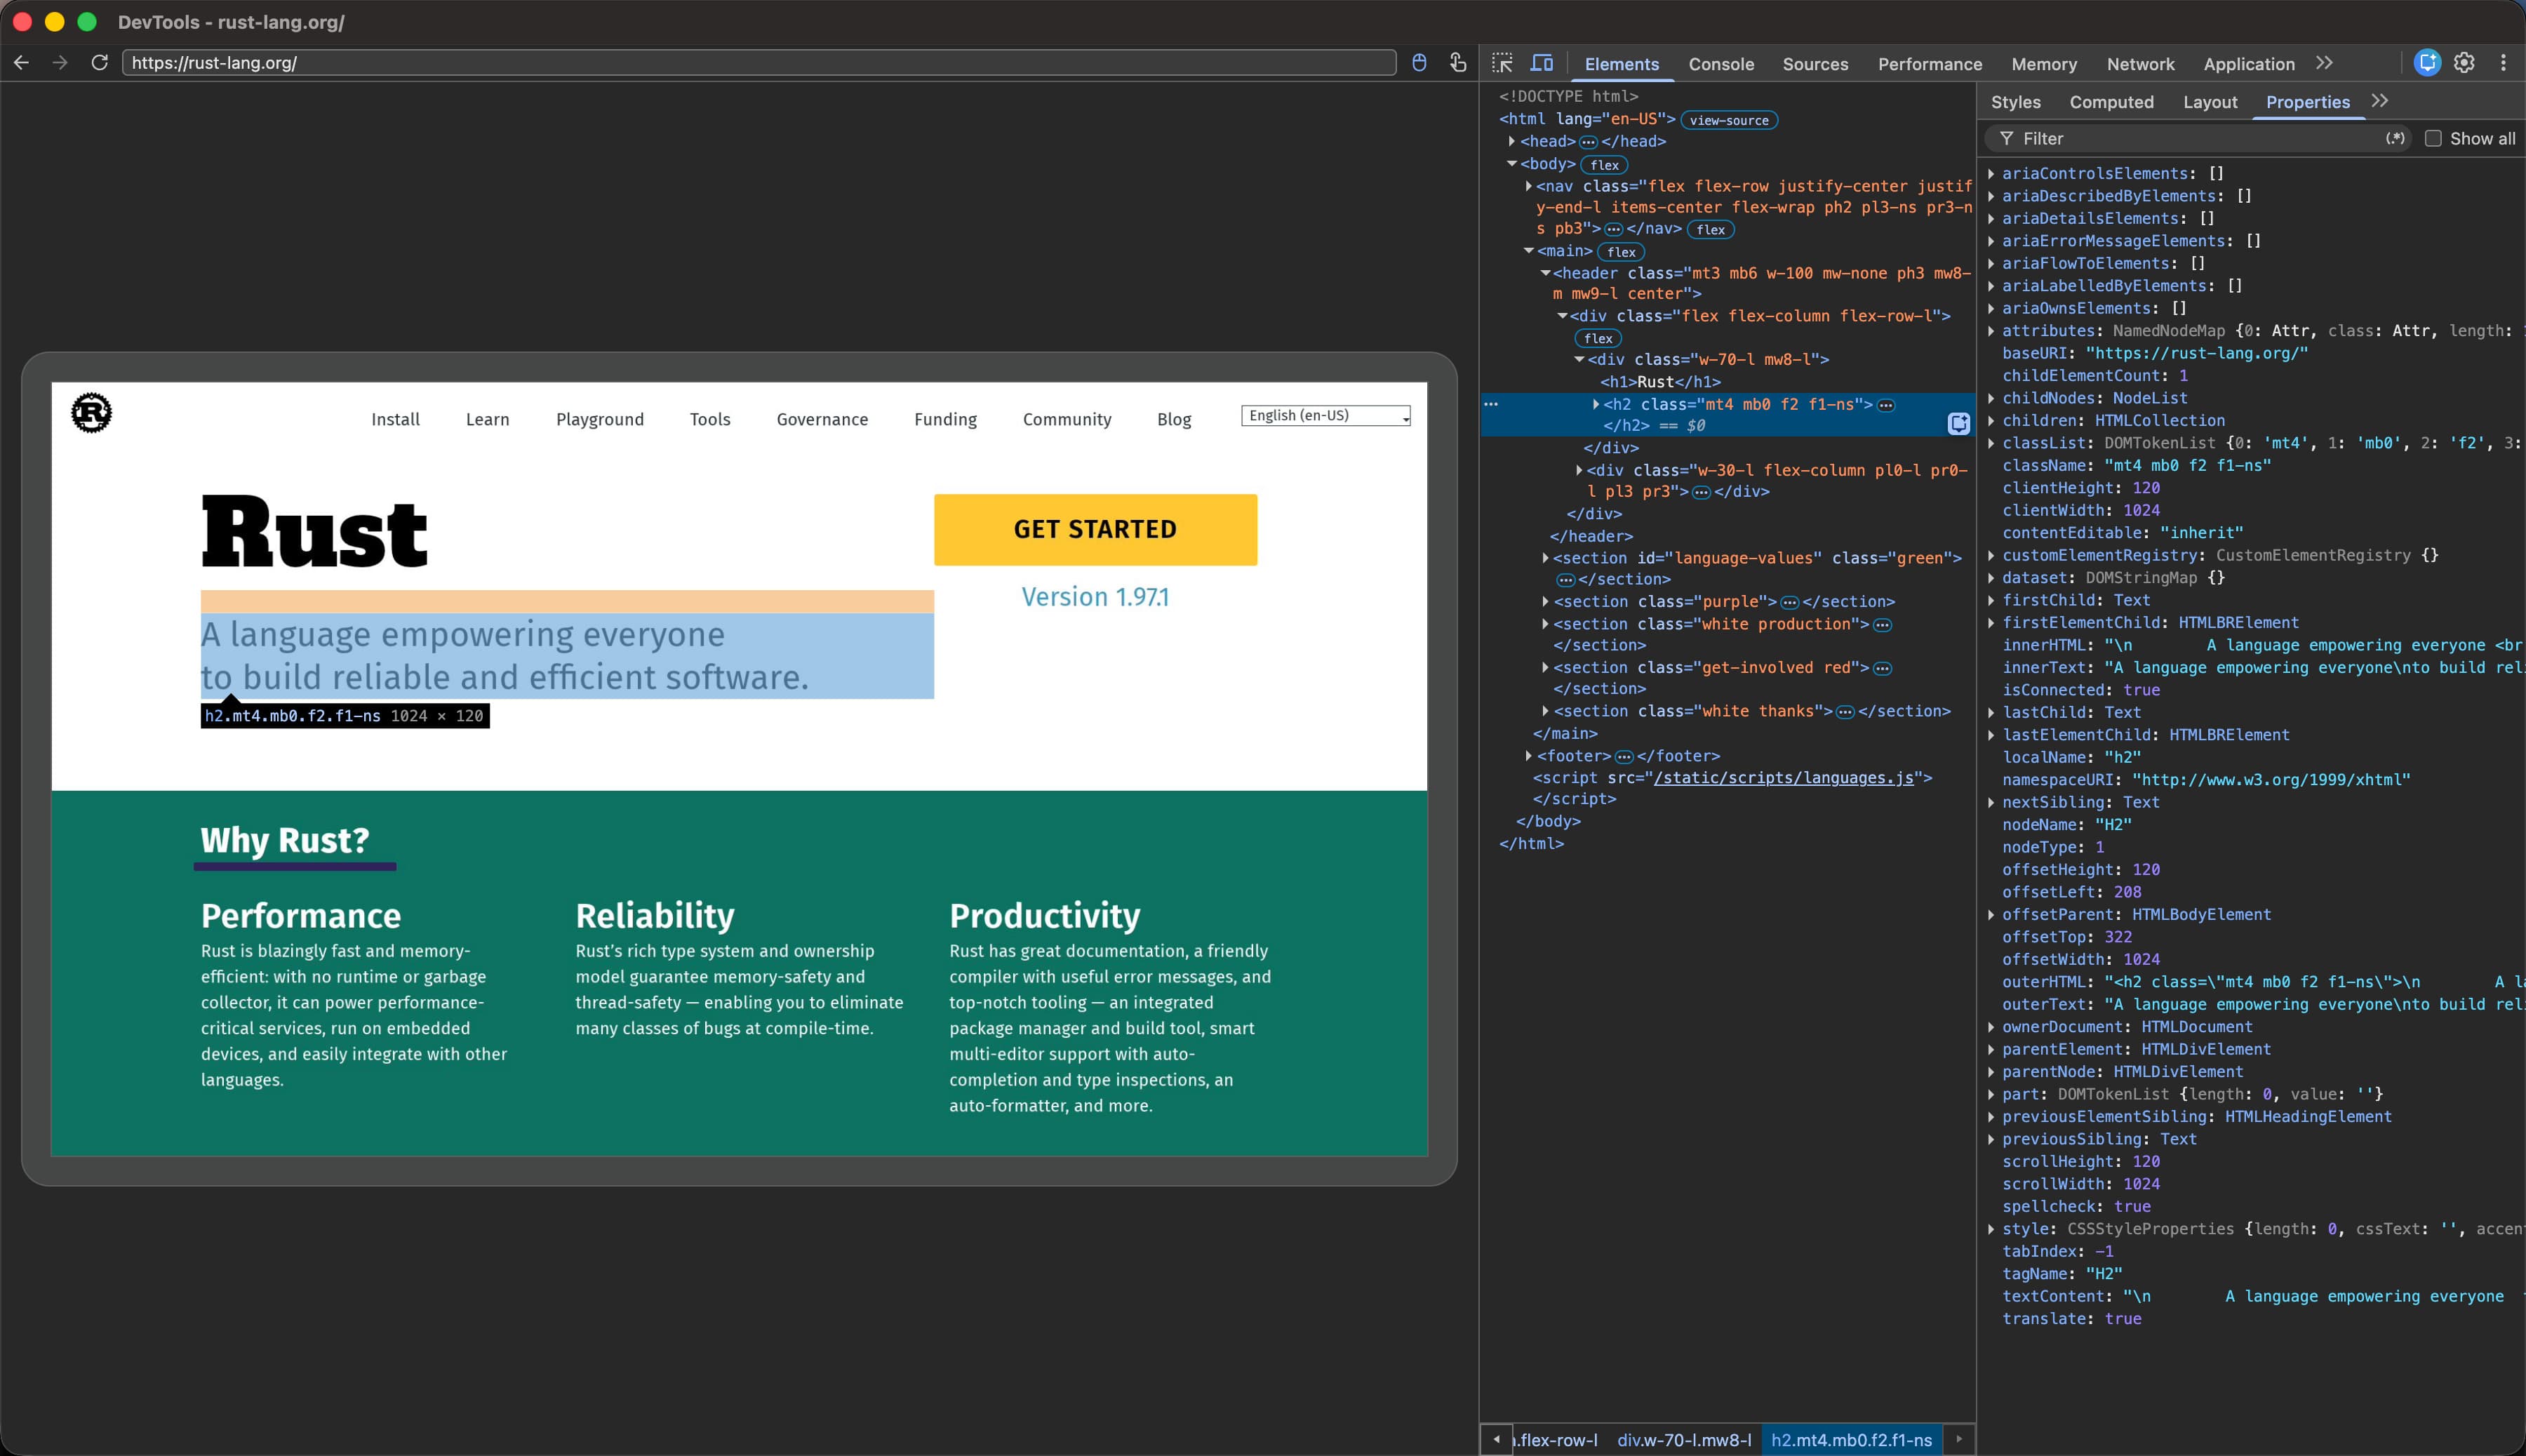
使用 Chrome DevTools 连接和打开 rust-lang.org, DOM、CSS、和元素选择器均正常工作.
我们甚至能在 Moli 里跑一个基于 Canvas + requestAnimationFrame + 键盘输入的完整格斗游戏模拟器:

为什么用 Rust 实现
Moli 不是凭空诞生的。
Rust 生态已经拥有一批高质量的浏览器基础组件:Servo/Stylo 提供 CSS parser、selector、cascade 和 computed style,html5ever 提供 HTML parsing,rusty_v8 提供 V8 的 Rust bindings,Taffy 提供 layout algorithms,Parley 提供文本排版,AnyRender/Vello CPU 提供软件 raster 基础,usvg 与 Rust image 生态提供 SVG 和位图处理。
没有这些项目,Lexmount 浏览器团队不可能以现在的团队规模和时间,重建一条从网络、DOM、脚本到 layout 和软件渲染的完整 browser pipeline。Moli 的创新不在于把所有底层算法重新发明一遍,而在于 围绕 Agent 重新定义浏览器的形态。
完整浏览器也是对这些基础组件最严苛的压力测试:不可信网页输入、长时间运行、异步并发和大规模 真实站点,会暴露出示例和单元测试里看不到的兼容性、资源边界和安全问题。开发和部署 Moli 的过程 中,我们已经发现并修复了其中一部分。
我们不希望 Moli 只是 Rust 浏览器生态的消费者。能够独立复现、并适用于通用生态的修复、测试与安全 加固,我们会逐步贡献给上游;涉及安全的问题会先与维护者协作完成负责任披露和修复,再公开技术 细节。Moli 将把真实 Agent Browser 负载带来的工程经验重新交还给这个生态。
性能数据
完整的 Web 支持不意味着性能的妥协,面向 Agent 重新设计浏览器,能够带来数量级上有意义的系统收益。
上面我们介绍了 Moli 的能力数据,这里集中介绍一下性能数据:
在 Lexbench-Headless-Browser 测试中,moli 使用较小占用实现了更高的兼容性和功能支持:

在我们内部 RL 训练负载的观测结果如下:
| 指标 | Moli | Chromium |
|---|---|---|
| CDP ready | 34.85 ms | 169.37 ms |
| episode active p50 | 33.40 ms | 57.13 ms |
| peak PSS | 102.46 MiB | 348.82 MiB |
| process / thread peak | 1 / 24 | 11 / 123 |
Moli 的 peak PSS 约为 Chromium 的 1/3,idle PSS 约为 1/7。Moli 的平均冷启动速度约为 Chromium 的 5 倍。
这是另一段实际 RL 训练的实际负载情况(并发使用 64 个浏览器会话):左侧黄色是 Moli,右侧绿色是 Chromium:
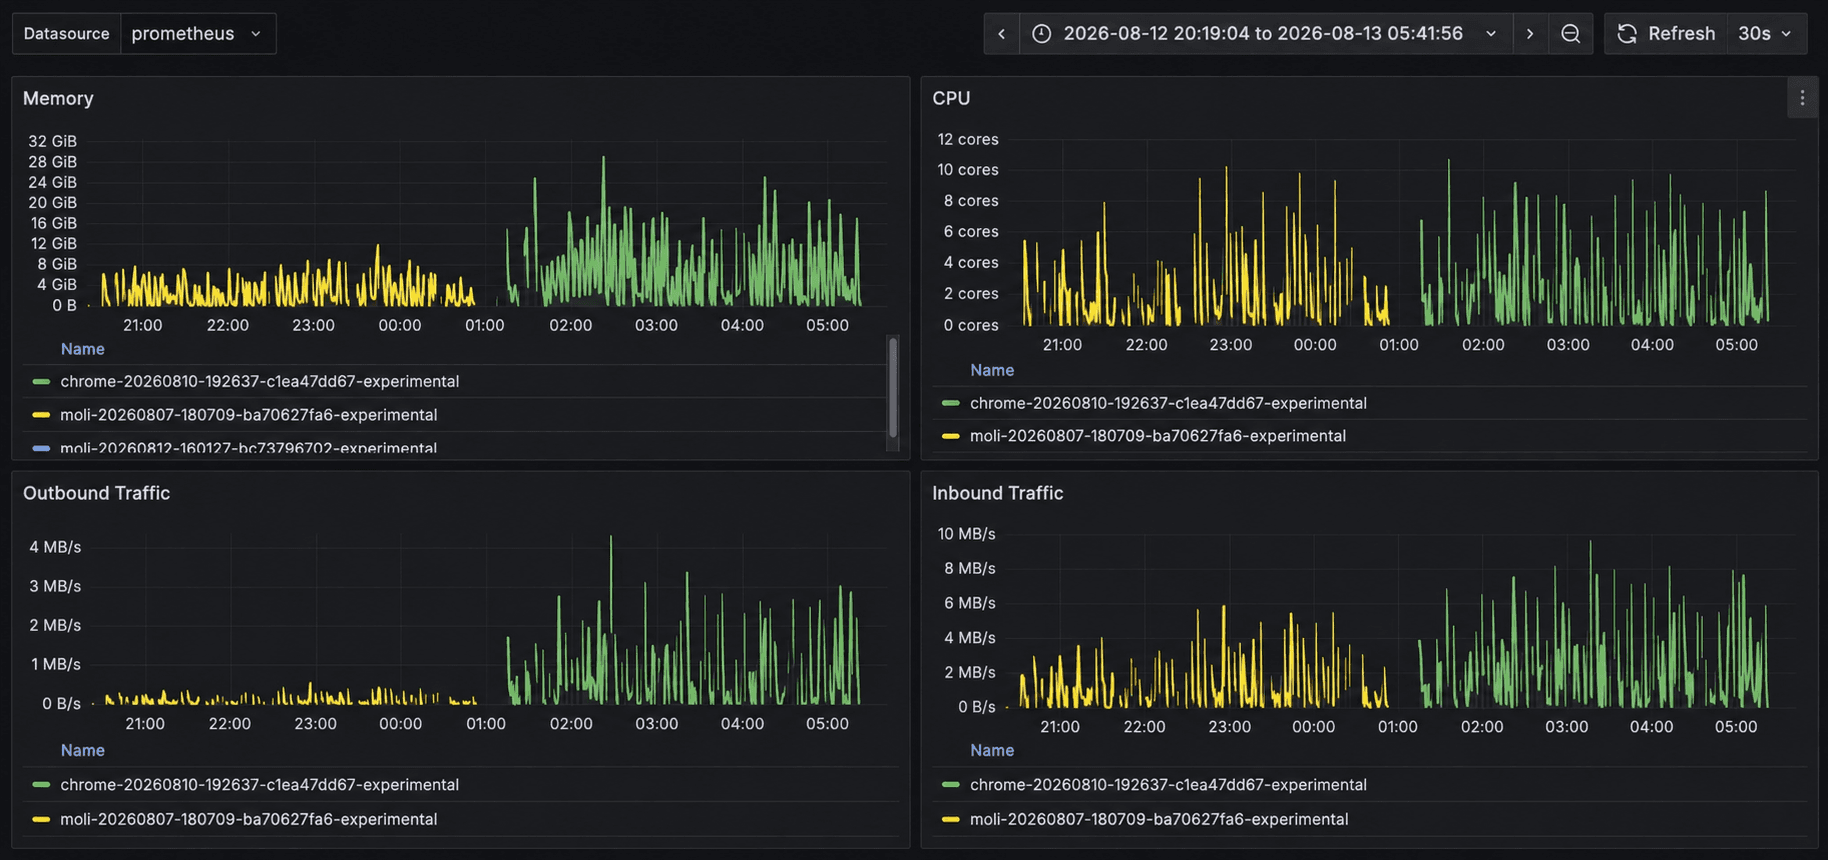
无论是大规模部署场景,还是边缘推理场景,Moli 都比 Chrome 更加高效。
结语
如果一个浏览器从第一天起就是为 AI Agent 设计的,它可能不是 Chrome 的样子。我们从 Agent 的视角重新做了一次取舍:让网页结构和执行能力始终存在,把布局、渲染和部分资源成本推迟到真正需要的时候;同时尽可能保留一个现代 Web Runtime 应有的兼容性。
到今天,Moli 已经初步达到了我们最开始设定的目标,也已经在真实生产负载中运行。因此我们决定把它开放出来。我们希望 Moli 不仅服务于 Lexmount,也能成为 AI Agent 使用者一个新选择。
我们并不知道未来的 AI Browser 最终会长成什么样。但我们越来越确信,它不会只是传统浏览器外面再套一层 Agent SDK。当浏览器的主要使用者发生变化,浏览器本身也值得被重新设计一次。
这就是 Moli。
现在就可以试试! https://github.com/lexmount/moli