

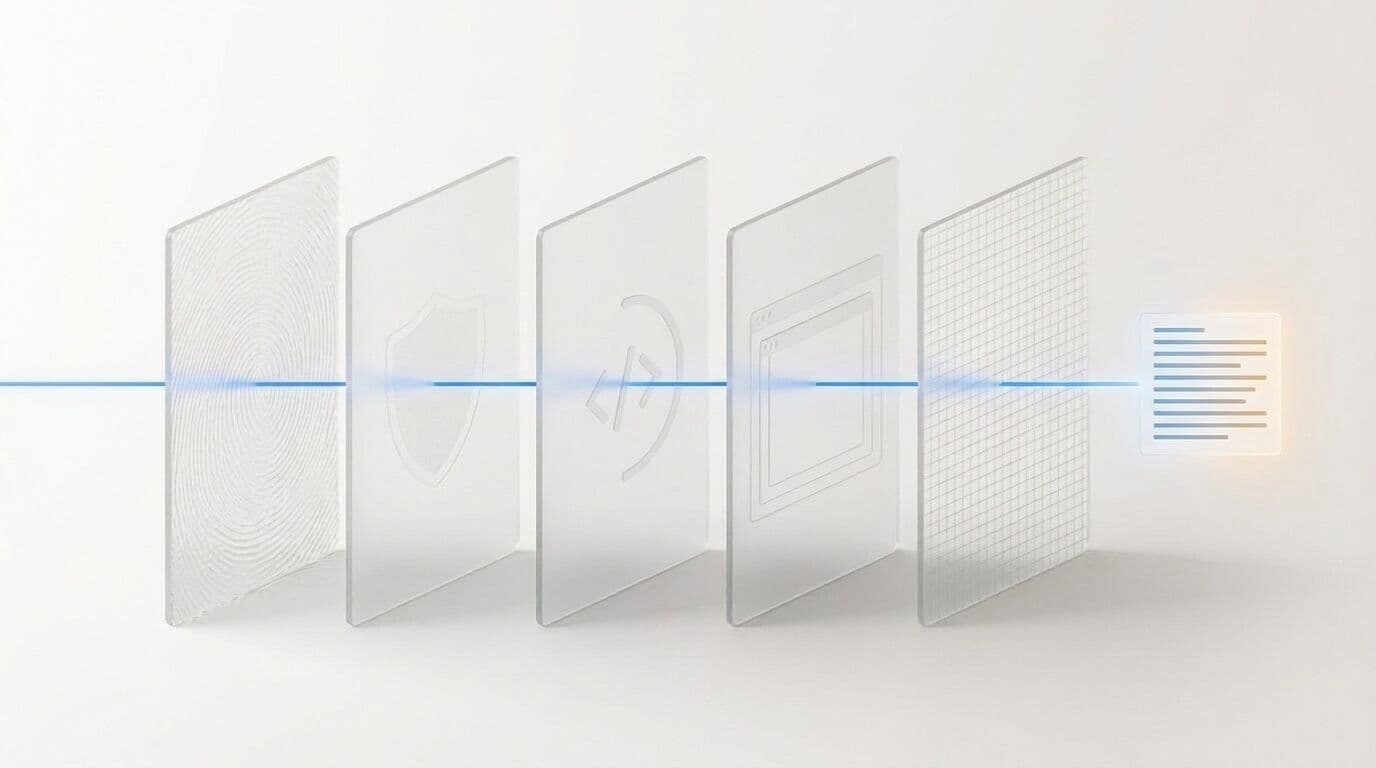
让 Agent 读取一个网页,难点不只是把 URL 变成文本。它需要拿到真正的页面内容,处理动态加载,再把有用的信息完整交给模型。Lexmount Web Fetch 将这些步骤封装为一次 API 调用,而支撑这条链路的浏览器能力,决定了它在真实网站上的表现。
下面这份评测从 Moli 的访问、渲染和提取能力出发,展示我们如何检验这些优势。文章保留了本轮测试的结果、方法和复现入口,帮助你把 Web Fetch 的实际需求与具体指标对应起来。
Moli 以 89.8% 通过率拿下 Web Fetch 第一
风控、热门、动态网站,也能稳定获取、准确提取
我们用两套基准横评了五款浏览器。一套是揽岳自建的 lexbench-webfetch,430 个用例全部来自真实网站,看浏览器能不能把内容取回来;另一套是公开基准 WebMainBench,545 个网页都预先存好,看正文提取得准不准。Moli 在真实网站上的任务通过率是 89.8%,正文提取的综合分是 39.27,两项都排第一。它领先最多的,正是决定 Web Fetch 成败的那一步:能不能触达网站。
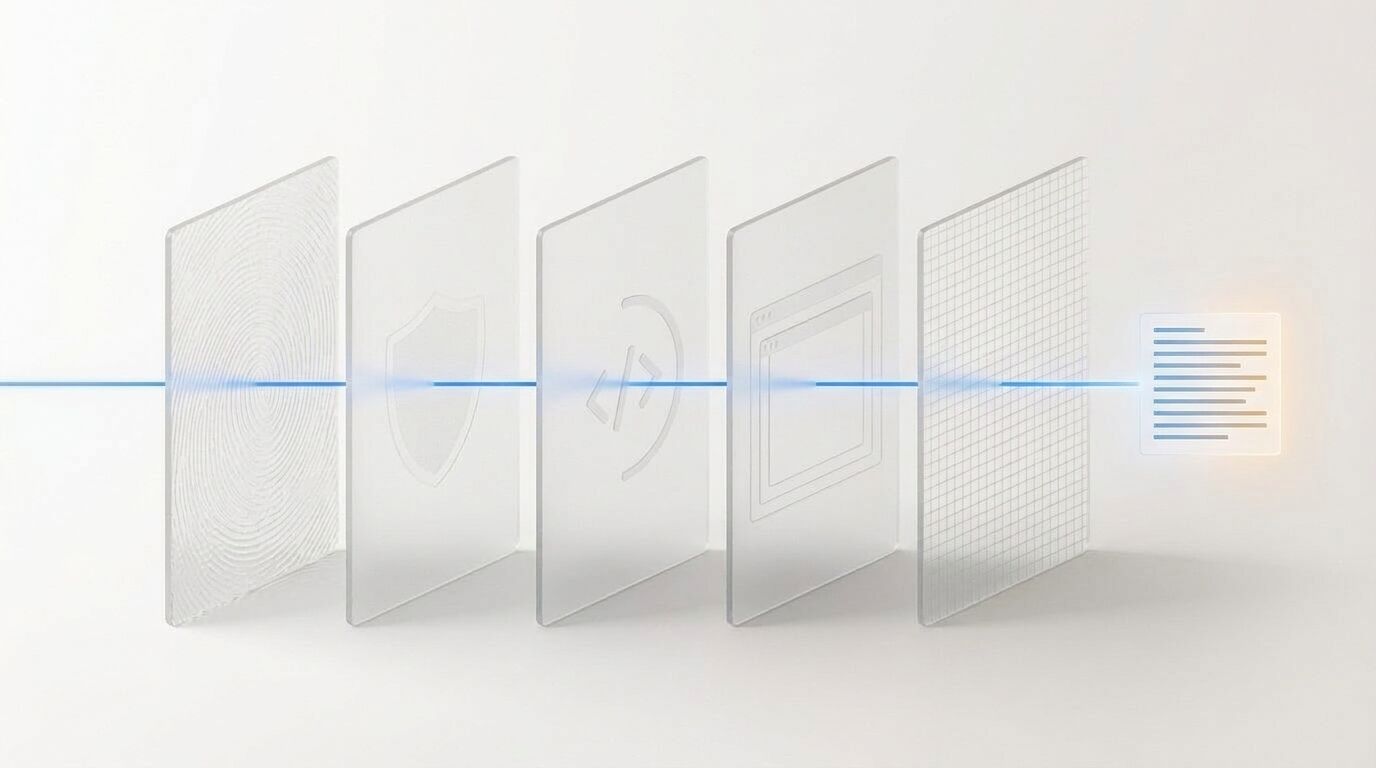 URL访问渲染提取①指纹检测②风控拦截③JS 渲染④iframe 嵌套⑤正文提取Markdown ✓
1|背景:Web Fetch 与 Moli
Agent 回答问题、做调研,往往要先去网上查资料。给它一个 URL,它把页面上的正文取回来,整理成 Markdown 交给模型去读,这一步就是 Web Fetch。
# Attention Is All You Need
## Abstract
The dominant sequence transduction models are based on …
这一步要在浏览器里完成。现在大多数 Agent 用的还是 Chrome 或 Chromium。它们是给人用的浏览器,功能齐全,但很吃资源,自动化的痕迹也容易被网站认出来。一些轻量浏览器为了省资源砍掉了部分能力,碰到动态网页,内容又常常取不全。
Moli[1] 就是为 Agent 重新设计的浏览器。它是揽岳智能开发的无头浏览器,没有在 Chromium 上做改造,而是用 Rust 从零写了一个内核:默认只处理 DOM,等 Agent 真正需要时,才去做布局和渲染。我们想让 Agent 获取和操作网页时,更快、更准、也更省。
这篇文章只讲 Web Fetch,在网页上点击、输入的 Browser Automation 留到后续文章。Web Fetch 听上去只是“打开网页、转成文本”,放到真实网站上,却要连过好几道关,也就是题图里的三个阶段。先是访问:浏览器的指纹和行为不能被风控系统识破,网站才会返回真正的页面。然后是渲染:JavaScript 要执行完,iframe 里的内容也要加载出来。最后才轮到提取:去掉导航和广告,把正文整理成 Markdown。哪一关没过,Agent 得到的都不是它想要的内容。
2|结果总览
参加对比的五款浏览器是 Moli、Chromium、Lightpanda、Obscura 和 Kitesurf。
两套评测的排名
lexbench-webfetch 按任务通过率排名,WebMainBench 按综合分排名。

有意思的是,两套评测的第二名并不是同一款浏览器。Chromium 在真实网站上排第二,正文提取却排在最后;Lightpanda 正好反过来,正文提取排第二,真实网站只排第三。两边都排第一的,只有 Moli。
为什么会这样?这要从两套评测各自测的东西说起。
3|评测方法
这次评测用了两套基准:公开的 WebMainBench,以及揽岳自建的 lexbench-webfetch。
3.1 公开基准 WebMainBench
WebMainBench[2] 是 OpenDataLab 发布的网页正文提取基准,收录了 545 份预先保存的网页,每份都附有人工标注的正文。评测时,所有浏览器处理的是完全相同的 HTML,比的是转出来的 Markdown 是否完整、准确地保留了正文。评分分五个维度,综合分取五项的平均值:
| 维度 | 网页数 | 看什么 |
|---|---|---|
| 全文 | 545 | 正文完整、准确,不混入导航和广告 |
| 代码 | 110 | 代码块完整保留 |
| 公式 | 257 | 数学公式正确保留 |
| 表格内容 | 179 | 单元格文字正确 |
| 表格结构 | 179 | 行列结构完整还原 |
输入固定,网络和风控的影响就都被排除在外,所以 WebMainBench 很适合单独比较正文提取的质量。
3.2 为什么要自建 lexbench-webfetch
但对 Agent 来说,只看提取质量还不够。WebMainBench 和大多数公开的网页提取基准[2]一样,有几个共同的局限:
只有静态快照。网页事先存成 HTML,评测时并不真正访问网站,网络、加载、超时这些真实环境里的问题都测不到。
人工标注不完整。标准答案靠人工标注,难免有漏标的内容。浏览器提取得更完整,分数却不一定更高。
没有真实网站的挑战。快照里没有风控拦截,也不需要执行 JavaScript、加载 iframe,而 Agent 在实际使用中最常卡住的,恰恰是这几个环节。
也就是说,这些基准回答的是“取回来的内容准不准”,却没有回答更前面的问题:能不能把内容取回来。这正是揽岳智能推出 lexbench-webfetch[3] 的原因。
3.3 lexbench-webfetch 的设计
lexbench-webfetch 直接在真实网站上评测。用例从最初的 150 个扩充到 430 个,标准答案都经过多轮人工审核。设计时,我们定了三条原则:
🌐 实时访问
访问真实网站,不用快照
⚓ 评分稳定
不考热榜、价格这类易变内容
🧗 覆盖复杂网站
重点纳入风控、动态和热门网站
430 个用例分成七类。静态网站是基础,风控、动态和热门网站各 100 个,是这套基准的重点;另外还有少量内嵌文档和媒体用例:
| 类别 | 用例数 | 怎样算通过 |
|---|---|---|
| 静态网站 | 100 | 正文完整 |
| 动态网站 | 100 | JavaScript 生成的目标内容确实出现 |
| 热门网站 | 100 | 正文稳定,条目和链接数量达标 |
| 风控网站 | 100 | 返回目标页面,而不是挑战页或验证码页 |
| 内嵌文档 | 10 | 取回 PDF、DOCX 的标题和正文 |
| 媒体信息 | 17 | 返回有效的图片、视频链接 |
| 媒体直链 | 3 | 取回的文件与原文件一致 |
两套基准正好互补:一套固定输入,只比提取;一套放到真实网站上,从访问一路比到提取。
3.4 参评浏览器与评测规则
为了比得公平,我们让每款浏览器都用它最合适的方式参加评测。有原生 Markdown 接口的,就直接用原生接口;Chromium 没有这样的接口,我们取它渲染后的 HTML,再用 node-html-markdown 统一转换;Kitesurf 是远程浏览器服务,就直接调用它的官方 API。
| 浏览器 | 简介 | 运行方式 | 调用方式 |
|---|---|---|---|
| Moli[1] | Rust 编写,专为 Agent 设计 | 本地 | 原生 Markdown 接口 |
| Chromium[6] | Chrome 的开源内核 | 本地 | HTML,经 node-html-markdown 转换 |
| Lightpanda[7] | Zig 编写,不做图形渲染 | 本地 | 原生 Markdown 接口 |
| Obscura[8] | Rust 编写,基于 V8 | 本地 | 原生 Markdown 接口 |
| Kitesurf[9] | Cloudflare 的远程浏览器 | 远程 | 官方 /markdown API |
接口可以不同,规则必须一样。在 lexbench-webfetch 上,五款浏览器遵守同一套规则:
4|WebMainBench 正文提取质量
WebMainBench 各维度得分
绿色为该维度的最高分。

Moli 的综合分是 39.27,比第二名 Lightpanda 高 4.27 分。最突出的是代码一项,Moli 得了 91.06 分,比第二名高 6.35 分;其余四项虽然不是第一,但都排在前三,和最高分的差距不超过 3.2 分。
其他浏览器则多少有些偏科:Obscura 的两项表格得分接近 0,Chromium 的代码只有 35.86 分。偏科的代价不小。代码、公式和表格往往是网页里信息最密集的部分,少了其中任何一类,Agent 后面的推理和回答都可能出错。
5|lexbench-webfetch 真实网站获取结果
5.1 请求成功不等于任务通过
请求成功率与任务通过率
空心点为请求成功率,实心点为任务通过率。

请求成功,只说明网站有了响应,返回的未必是正文。Chromium 的请求成功率高达 96.7%,几乎每个网站都“打开”了,真正通过验收的却只有 54.4%。中间差出来的 42.3 个百分点,返回的是挑战页、空白的页面框架,或者只有一半的内容。Moli 的两项指标只差 6.5 个百分点:页面返回了,内容基本也是对的。
5.2 各类用例的通过情况
五款浏览器在 430 个用例上的通过情况
每一格代表一个用例,着色为通过,浅灰为未通过。每类中通过的格子排在前面。

静态网站是大家都能通过的部分,五款浏览器都在 90 个以上,差别不大。真正拉开差距的是风控、热门和动态网站:Moli 分别通过了 88、91、90 个,其他浏览器在这三类上最好的成绩只有 37、58、58 个。Moli 比第二名 Chromium 多通过了 152 个用例,其中 148 个都来自这三类,而它们也正是 Agent 在实际使用中最容易失手的网站。
内嵌文档正好相反,五款浏览器基本都过不了,每款都只通过了 1 个。原因我们放到后面细说,先来看风控和动态网站。
5.3 风控网站:反爬虫检测与 Moli 的应对
风控网站的通过数(共 100 个用例)
返回挑战页或验证码页即判为未通过,即使状态码是 200。

风控网站会部署反爬虫系统,从好几个层面判断来访的到底是不是真实的浏览器。哪一层露出破绽,网站返回的就是挑战页或验证码,而不是正文。这 100 个用例来自 74 个不同的站点,功能最完整的 Chromium 在这里只通过了 5 个。
常见的检测有五层,Moli 在每一层都有对应的做法:
Moli 的思路是从根上避免露馅。它是独立内核,本身就没有无头 Chromium 的那些自动化痕迹;浏览器的各项属性都在内核里原生实现,不靠注入脚本去改写,并且通过了 161 万项 Web Platform Tests 标准测试。在此基础上,揽岳智能(Lexmount)的内核团队又针对浏览器指纹和访问行为做了专项优化。遇到支持 Web Bot Auth 的网站,Moli 还可以用可验证的签名,大大方方地表明自己的 Agent 身份。
5.4 动态网站:JavaScript 渲染与 iframe 加载
动态网站的正文,并不在服务器最初返回的 HTML 里,而是等页面打开后,由 JavaScript 生成出来,有时还套在 iframe 里。iframe 可以理解成“网页里嵌着的另一个网页”:屏幕上看是一整页,源码里其实是两份文档。
<h1>商品目录</h1>
<iframe src="list.html"><li>条目 1</li>
<li>条目 2</li> …由 JS 生成# 商品目录
(列表缺失)# 商品目录
- 条目 1
- 条目 2
- 条目 3浏览器得先把脚本执行完,再把 iframe 里的文档也加载进来,才能看到完整的内容。Moli 的内核集成了 V8、html5ever、Stylo 和 libcurl 等开源组件,能完整执行页面上的 JavaScript。iframe 则是 Lightpanda 的弱项:遇到依赖 iframe 的动态网页,它常常只返回外层页面,100 个动态用例只通过了 44 个,Moli 通过了 90 个。
5.5 未通过用例分析
430 个用例里,Moli 还有 44 个没有通过:16 个是请求本身就失败了,另外 28 个返回了内容,但没过验收。
Moli 未通过的 44 个用例
括号内为该类别的用例总数。
没过的用例里,风控网站最多,还有 12 个。反爬虫是一场持续的攻防,Moli 已经能应对指纹、行为等大部分检测,内核团队还在继续改进。
内嵌文档的 9 个,情况不太一样,它们来自我们有意做的一个取舍。
网页里嵌的 PDF、DOCX 并不是 HTML,而是独立的文档格式,要读出里面的标题和正文,得有专门的文档解析器。无头浏览器一般都不内置这类解析器,所以五款浏览器在这 10 个用例上都只通过了 1 个。Moli 也没有内置,这并不是做不到,而是希望内核专注于网页本身,保持轻量。Agent 真要读文档,把文件交给专门的解析工具,效果会更好。
6|资源开销

同样的任务,Moli 的 CPU 时间中位数约为 Chrome 的 1/7,峰值内存约为 1/7.6。对需要大规模并发获取网页的 Agent 来说,这意味着同一台机器可以同时运行更多的浏览器实例。
不过,Moli 目前还不是资源占用最低的浏览器。更轻的方案,往往要舍掉一部分渲染能力。我们的选择是先保证内容取得完整、准确,再在这个前提下继续压低开销。
7|总结与展望
Web Fetch SOTA
更大规模、更少失败
Browser Automation
Web Fetch SOTA
更大规模、更少失败
Browser Automation
回头看这次对比:五款浏览器、两套基准,Moli 在真实网站获取和正文提取上都排第一,资源开销约为 Chrome 的七分之一。
我们尽量把这次对比做得客观。每款浏览器都用了它最合适的调用方式,所有结果都经过多轮复核,没有为了分数厚此薄彼。评测代码和用例都已开源,如果你发现配置或判分上的问题,欢迎告诉我们。
接下来,我们会把真实网页测试从现在的约 1,000 个页面扩展到 1 万、10 万个,并把没通过的用例逐个解决,让 Moli 成为 Agent 在生产环境中获取网页的最佳选择。
当然,获取网页只是第一步,Agent 还要在网页上点击、输入、提交,把事情真正办完。后续文章中,我们会介绍 Moli 如何在更复杂的 Browser Automation 任务上取得 SOTA。
附录|开源与复现
本文的全部结果都可以用 Browser Eval[4] 复现:它统一驱动五款浏览器,运行两套基准,完成计分与复核,并生成逐题报告。
由于测试访问的是实时网站,重跑时个别站点的结果可能会有小幅波动。
参考
- Moli:Lexmount 开源的 Agent 浏览器。
- WebMainBench:OpenDataLab 的网页主内容提取基准。
- lexbench-webfetch:Lexmount 开源的真实网站 Web Fetch 基准。
- Browser Eval:Lexmount 开源的浏览器评测框架。
- Lexbench-Headless-Browser:Lexmount 的无头浏览器基准,成本数据来源。
- Chromium,以及 Playwright、node-html-markdown。
- Lightpanda:Zig 编写的无头浏览器。
- Obscura:Rust 编写的无头浏览器。
- Kitesurf:Cloudflare 的远程浏览器服务。